作业3:在 Langfuse 中追踪 Agent 工具调用验收(配置/调试/重启全流程)
本文档用于复现作业3:确保在 Langfuse 后台能看到 Agent 每一次工具调用的详情(工具名、输入输出、耗时、以及 token/总耗时)。
你将按本文完成:配置 tracing → 打补丁 → 重启 worker → 触发 Agent → 轮询验收 → UI 复核。
运行环境:业务脚本均在 207 固定目录
/opt/workbuddy执行,Python 为/usr/bin/python3。 Windows 开发机仅保留_probe_*调试脚本;同步命令:python scripts_cursor/完整代码约定/00_部署_workbuddy到207.py。
0. 与作业1/作业2的关系
- 作业1:
作业1_带工具调用的Agent_服务器状态_cursor.md(提供工具getServerStatus的使用场景) - 作业2:
作业2_客服意图路由工作流_cursor.md(提供工作流/Agent 路由思路与习惯) - 作业3:本页(把“工具调用”真正打进 Langfuse 的观测链路)
(你也可以把本文理解成:把作业1里的工具调用可观测化。)
1. 目标与验收标准(逐条对应)
当你完成本文的端到端操作后,必须满足:
- 能找到完整 Trace(trace input/outputs 对得上你发起的
query) observations中至少存在一条工具 Observation(工具名getServerStatus,且它是type=SPAN)- 工具 Observation 的 input/output 非空
- 该工具步骤存在耗时信息(至少
startTime/endTime或 duration 字段之一) - generation(llm)里能看到 token 统计(
promptTokens/completionTokens/totalTokens或同等字段)
UI 验收建议从: Tracing -> Observations(筛选 Name=getServerStatus)开始,而不是只看 Message 面板。
2. 理论支撑:为什么“看不到工具子链路”
2.1 Dify -> Langfuse 的数据链路是异步的
- 新 Agent 在对话结束后把 Trace 任务丢给 Celery(worker)异步补报
- 因此 UI 不会“点发送立刻出现”,你必须给出轮询/等待时间
2.2 Langfuse 里 Generation 与工具 Span 是不同类型
GENERATION:name=llm,包含 token usage(你关心的totalTokens通常在这里)SPAN:工具调用(本作业里对应name=getServerStatus)
2.3 UI 的“子链路图/父子渲染”依赖 parentObservationId
你在实战里遇到的核心坑是:
- 工具
SPAN虽然写入了 Langfuse(API 能查到 input/output) - 但
parentObservationId是null,UI 的“工具子链路”不会把它挂到llmgeneration 下显示
本作业通过补丁保证:
- 工具
SPAN明确设置parent_observation_id - 并让
llmgeneration 有可引用的稳定 id(否则 parent 无从对应)
3. 端到端实现流程(配置 -> 调试 -> 重启 -> 验收)
下面所有步骤按顺序执行,不要跳步。
学习路径:本节等价于其它作业的「第三部分 详细操作步骤」。下表是 步骤 0~6 四要素速查;每步下方仍有完整 curl;第 5 节 有 6 条实战排错。
| 步骤 | 干什么 | 触发什么 | 成功标志 | 典型失败 |
|---|---|---|---|---|
| 0 登录 | 拿 cookie + CSRF | POST /login | 能 echo 出 CSRF | 密码未 base64 |
| 1 开 tracing | 按 app 配 Langfuse | PATCH trace-config + enable | trace 开关为 true | 只配全局 env 无效 |
| 2 打补丁 | 改 langfuse_trace.py | 复制到 api+worker 并 restart | 容器内文件含新 MARKER | CRLF 导致锚点找不到 |
| 3 发对话 | Agent streaming | 调作业 1 工具 + 产生 trace | HTTP 200,SSE 有 tool | Connection error |
| 4 轮询 obs | 等 Langfuse 异步入库 | GET observations API | 出现 TOOL 类型 span | 查太早为空 |
| 5 自动验收 | 作业3_验收Langfuse工具调用.py | 断言 parent/child/tool 名 | 脚本 PASS | traceId 匹配到旧的 |
| 6 UI 复核 | Langfuse 网页看树形图 | 人工确认子链路 | 能看到工具 Span | UI 缓存,硬刷新 |
本作业追踪的就是作业 1 的 Agent(真实 ID,写死在 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/_config.py):
| 项 | 值 |
|---|---|
| 控制台 | http://192.168.110.207 |
| Dify 控制台 API(207 本机) | http://127.0.0.1/console/api |
| app_id | d00d0382-ca3f-4cf2-9cc9-0cb5aed9404d |
| agent_id | 01a0189c-7d7e-742f-83d1-74c5c16878da |
| 验收问句 | 帮我看看 gpu-server-01 的状态 |
| Langfuse | http://192.168.110.207:3000 |
| Langfuse pk/sk | /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/_config.py 的 LANGFUSE_PK / LANGFUSE_SK |
日常验收请直接跑 Python。下面每一步都给出 207 上可复制的完整 curl(与 dify_api.py 一致:在 207 本机打 127.0.0.1)。207 上执行 /usr/bin/python3 /opt/workbuddy/scripts_cursor/...。
步骤 0:控制台登录(后续 curl 都依赖 cookie + CSRF)
Dify 1.16 登录密码必须 base64。账号密码见 _config.py(DIFY_EMAIL / DIFY_PASSWORD)。
ssh root@192.168.110.207
rm -f /tmp/dify_cj.txt
python3 - <<'PY'
import json, base64
open("/tmp/dify_login.json", "w").write(json.dumps({
    "email": "38205036@qq.com",
    "password": base64.b64encode(b"Difyai123456").decode(),
    "language": "zh-Hans",
    "remember_me": True,
}))
PY
curl -s -c /tmp/dify_cj.txt -X POST 'http://127.0.0.1/console/api/login' \
  -H 'Content-Type: application/json' \
  -d @/tmp/dify_login.json
CSRF=$(python3 - <<'PY'
jar=open("/tmp/dify_cj.txt").read()
for line in jar.splitlines():
    if "csrf_token" in line:
        print(line.split("\t")[-1].strip())
PY
)
echo "CSRF=$CSRF"
后面命令都假设已经 export CSRF=... 且 cookie 在 /tmp/dify_cj.txt。
步骤 1:启用 Dify 应用的 Langfuse tracing(按应用配,不靠全局 env)
推荐一键(内部就是下面这几条完整 HTTP):
# 207 服务器
/usr/bin/python3 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/作业3_验收Langfuse工具调用.py
手工等价(先完成步骤 0 登录)。
1A. 查当前 tracing 配置
curl -s -b /tmp/dify_cj.txt -H "X-CSRF-Token: $CSRF" \
  'http://127.0.0.1/console/api/apps/d00d0382-ca3f-4cf2-9cc9-0cb5aed9404d/trace-config?tracing_provider=langfuse'
1B. 写入 Langfuse pk / sk / host(未配置用 POST;已配置可改 PATCH,失败再 POST)
curl -s -b /tmp/dify_cj.txt -c /tmp/dify_cj.txt \
  -H "X-CSRF-Token: $CSRF" -H 'Content-Type: application/json' \
  -X POST 'http://127.0.0.1/console/api/apps/d00d0382-ca3f-4cf2-9cc9-0cb5aed9404d/trace-config' \
  -d '{
    "tracing_provider": "langfuse",
    "tracing_config": {
      "public_key": "pk-lf-84a76d89-b6b4-4943-b4ea-2dee48d4cda7",
      "secret_key": "sk-lf-24aa6d73-ed36-4447-9eb6-3ebd446fb298",
      "host": "http://192.168.110.207:3000"
    }
  }'
1C. 打开开关 enabled
curl -s -b /tmp/dify_cj.txt -c /tmp/dify_cj.txt \
  -H "X-CSRF-Token: $CSRF" -H 'Content-Type: application/json' \
  -X POST 'http://127.0.0.1/console/api/apps/d00d0382-ca3f-4cf2-9cc9-0cb5aed9404d/trace' \
  -d '{"enabled": true, "tracing_provider": "langfuse"}'
1D. 核对开关
curl -s -b /tmp/dify_cj.txt -H "X-CSRF-Token: $CSRF" \
  'http://127.0.0.1/console/api/apps/d00d0382-ca3f-4cf2-9cc9-0cb5aed9404d/trace'
步骤 2:打补丁到容器里的 langfuse_trace.py(必须打到两个容器 + 重启 worker)
你需要补丁两类能力:
1) Observation/Generation 补 UUID(body.id) 否则 Langfuse v4 可能直接跳过写入(Trace 进了但 llm/token 或 tool span 可能不进)。
2) Agent 工具调用 span 补写 + 父子链路绑定 通过读取 message_data.agent_thoughts,解析出 tool_name/tool_input/tool_output/time_cost,并写成 LangfuseSpan。
本系统用的可重复执行脚本是: /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/Langfuse_01_打langfuse_trace补丁_修改后.py
运行方式:
/usr/bin/python3 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/Langfuse_01_打langfuse_trace补丁_修改后.py脚本做了这些事:
- 同时 patch
C.DIFY_WORKER(docker-worker-1)和C.DIFY_API_CTR(docker-api-1) py_compile校验 patch 后代码语法- 重启 worker,等待日志出现
worker ready
手工等价(补丁必须用脚本写文件;重启可以单独打):
ssh root@192.168.110.207 'docker restart docker-worker-1'
ssh root@192.168.110.207 'docker logs --since 60s docker-worker-1 | tail -20'
步骤 3:触发 Agent 对话(streaming),提取最新 traceId
工具调用验收依赖作业 1 的 Agent 发问(触发 getServerStatus)。
推荐:
/usr/bin/python3 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/作业3_验收Langfuse工具调用.py手工等价(先完成步骤 0 登录):
curl -s -b /tmp/dify_cj.txt -c /tmp/dify_cj.txt \
  -H "X-CSRF-Token: $CSRF" -H 'Content-Type: application/json' \
  --max-time 420 \
  -X POST 'http://127.0.0.1/console/api/agent/01a0189c-7d7e-742f-83d1-74c5c16878da/chat-messages' \
  -d '{
    "inputs": {},
    "query": "帮我看看 gpu-server-01 的状态",
    "response_mode": "streaming",
    "files": [],
    "conversation_id": ""
  }'
从流式 JSON 里取出 "message_id": "<uuid>",当作本次 traceId(不要拿旧对话的 id)。
步骤 4:轮询 Langfuse observations(异步 ingestion 必须做)
Langfuse Public API 用 HTTP Basic(pk 当用户名、sk 当密码),不需要 Dify CSRF。
先看最近几条 trace 是否包含验收问句:
curl -s -u 'pk-lf-84a76d89-b6b4-4943-b4ea-2dee48d4cda7:sk-lf-24aa6d73-ed36-4447-9eb6-3ebd446fb298' \
  'http://192.168.110.207:3000/api/public/traces?limit=5'
再按本次 traceId(上一步的 message_id)拉 observations(可隔 3 秒重复执行,直到 data 非空):
TRACE_ID='这里换成上一步的 message_id'
curl -s -u 'pk-lf-84a76d89-b6b4-4943-b4ea-2dee48d4cda7:sk-lf-24aa6d73-ed36-4447-9eb6-3ebd446fb298' \
  "http://192.168.110.207:3000/api/public/observations?traceId=${TRACE_ID}"
步骤 5:自动验收关键断言
脚本对 getServerStatus 工具 span 做检查:
- 存在:
observations中确实能筛到name=getServerStatus - 不为空:tool span 的
input/output非空 - 耗时:存在
startTime/endTime - token:在
type=GENERATION且name=llm的 observation 中读取totalTokens
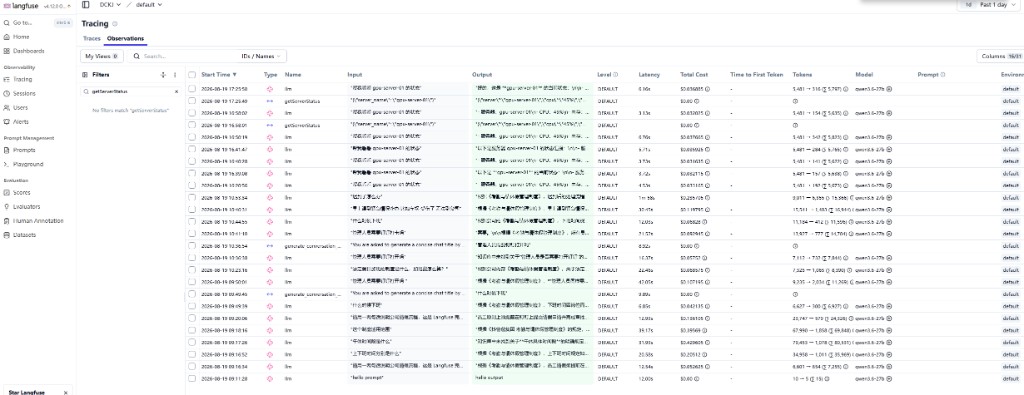
步骤 6:UI 手工复核(你这次就是卡在这里)
你应该这样看:
- 打开 Langfuse
- 进入
Tracing -> Observations - 筛选
Name = getServerStatus(或全局搜索该名字) - 点击该行
- 在右侧看到该条的
Input / Output / Metadata(以及 Latency/Start-End)
成功案例截图(作业3成功那张):
4. CPU / GPU 建议(两部分都详细)
4.1 CPU-only 环境建议(你当前主要场景)
目标:确保验收脚本“可观测”,而不是追求最短推理时间。
1) 时间窗与轮询
- CPU 推理更慢,Celery 推送完成与 Langfuse ingestion 出现会更晚
- 建议把“轮询次数/间隔”调大(本仓库脚本默认已做 10 次 * 3s,足够覆盖一般 CPU 延迟)
2) 影响字段
- 工具 Span 的
start/end会更明显拉开(时间更长) - token 总量与字段含义不变:依然在
GENERATION llm里
3) 工具输出适配
- 如果
getServerStatus本来只返回 GPU 字段,你在 CPU-only 上仍然可以复现 trace - 但建议你让工具输出包含至少:
- CPU 利用率
- 内存
- (GPU 字段可置空/N/A)
这样你在 Langfuse 的工具 output 会更完整,避免你以为“工具失败其实只是字段为空”。
4.2 GPU 可用后建议(预防未来复现)
目标:并行与吞吐调优,同时保持 trace 验收逻辑不变。
1) vLLM / Xinference 的 GPU 资源规划
- 建议优先确保:
max_model_len / context_size与你模型能力一致- 并发
max_num_seqs不要一开始拉满(避免延迟抖动影响你观察 start/end) - 记录实际 token/s(只影响耗时,不影响本作业验收字段结构)
2) 本作业的 trace 结构不依赖 GPU
- 工具 span 的出现完全取决于:
- 你是否打了
message_trace内的 tool span 补写 - 以及 tool span 是否挂了
parent_observation_id - GPU 只改变“tool_span 的耗时数字”,不会改变“工具调用是否存在于 observations”。
5. 出现的问题及其对应解决方案(作业3实战复盘)
下面按“你可能再次遇到的现象”来写。
问题 1:只有最终 LLM 返回,没有独立工具子链路
现象
- Observations 中找得到
getServerStatus的记录,但 UI 不显示为llm子节点/子链路
根因
parentObservationId=null,UI 无法做父子图渲染
解决方案
- 在
apply_langfuse_agent_tool_spans_patch()的 tool span 构造里显式设置: parent_observation_id=langfuse_generation_data.id- 并在
self.add_generation(langfuse_generation_data)之前确保: langfuse_generation_data.id = message_id(这样 parent 可以稳定引用)
如何验证
curl -u 'pk-lf-...:sk-lf-...' 'http://192.168.110.207:3000/api/public/observations?traceId=<message_id>'里工具 span 的parentObservationId不再为 null- UI
Tracing -> Observations点击 getServerStatus 后能看到 Input/Output
问题 2:查到的 traceId 不对/匹配到旧 trace
现象
- 验收脚本“找到了 trace,但工具不在里面”
根因
- streaming 返回中 UUID 提取正则没覆盖到最新 message_id
解决方案
- 验收脚本优先从 streaming tail 提取:
"message_id": "<uuid>"- 提取失败再回退:
find_trace_by_query()扫 trace input
如何验证
- 脚本输出中
traceId:应与本次对话一致
问题 3:observations 刚触发就查不到(异步补报)
现象
- 第一次拉 observations 为空
根因
- Langfuse ingestion 是异步的
解决方案
- polling loop(本仓库已内置:10 次,每次间隔 3 秒)
问题 4:Agent chat 偶发 400(tmux_error)
现象
- script 触发时 chat http code 非 200/201
解决方案
- 脚本对 chat-messages 做 3 次重试(每次失败后 sleep 6s)
问题 5:patch 锚点找不到(CRLF/换行符导致字符串比对失败)
现象
- 报 “message_trace 锚点未找到” 或 “旧块边界无法定位”
根因
- 容器文件存在
\r\n,本地 patch 字符串按\n比对失败
解决方案
_plugin_util.py的container_read()返回值做归一化:out.replace("\r\n", "\n")
问题 6:ClickHouse 查询报 unknown column total_tokens
现象
- 你以为 observations 表里有 total_tokens,但实际上不是直接列
解决方案
- 直接以 Langfuse API observations 为准,读取 generation 的
usage.totalTokens - 或查询
usage_details/usage的嵌套字段
6. 代码完整版(本次实战用到的关键脚本/完整函数)
说明:按你的要求,本节尽量给出“完整脚本/完整函数”,确保你能直接照着做。
6.1 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/作业3_验收Langfuse工具调用.py(完整脚本)
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""作业 3 · 验收:Langfuse 中能否看到 Agent 的每次工具调用详情。

验收目标(自动检查版):
1) Trace 存在(找到输入包含 query 的那条)
2) observations 里至少有一条工具 Observation(name=工具 operationId)
3) 工具 inputs / outputs 不为空
4) 至少能看到一步耗时(start/end 或 duration 字段之一)
5) generation 上能看到 token 统计(totalTokens / usage_details 等)
"""

from __future__ import annotations

import json
import sys
import time
import re
from typing import Any

import _bootstrap  # noqa: F401
import _config as C
from dify_api import Dify


def enable_trace_for_app(d: Dify, app_id: str) -> None:
    # 1) trace-config(langfuse keys + host)
    cfg = d.get("/apps/%s/trace-config?tracing_provider=langfuse" % app_id)
    if (cfg.get("json") or {}).get("has_not_configured"):
        r = d.post(
            "/apps/%s/trace-config" % app_id,
            body={
                "tracing_provider": "langfuse",
                "tracing_config": {
                    "public_key": C.LANGFUSE_PK,
                    "secret_key": C.LANGFUSE_SK,
                    "host": C.LANGFUSE_URL,
                },
            },
        )
        if r.get("code") not in ("200", "201"):
            raise RuntimeError("create trace-config failed: %r" % r)
    else:
        r = d.req(
            "PATCH",
            "/apps/%s/trace-config" % app_id,
            body={
                "tracing_provider": "langfuse",
                "tracing_config": {
                    "public_key": C.LANGFUSE_PK,
                    "secret_key": C.LANGFUSE_SK,
                    "host": C.LANGFUSE_URL,
                },
            },
        )
        if r.get("code") not in ("200", "201"):
            # 有些版本如果 PATCH 不适配,就退回 POST
            r2 = d.post(
                "/apps/%s/trace-config" % app_id,
                body={
                    "tracing_provider": "langfuse",
                    "tracing_config": {
                        "public_key": C.LANGFUSE_PK,
                        "secret_key": C.LANGFUSE_SK,
                        "host": C.LANGFUSE_URL,
                    },
                },
            )
            if r2.get("code") not in ("200", "201"):
                raise RuntimeError("patch trace-config failed: %r / %r" % (r, r2))

    # 2) enable trace
    r2 = d.post(
        "/apps/%s/trace" % app_id,
        body={"enabled": True, "tracing_provider": "langfuse"},
    )
    if r2.get("code") not in ("200", "201"):
        print("[WARN] enable trace returned code:", r2.get("code"))

    # 3) verify (方便判断是否真正启用了 ops_trace / trace_instance)
    print("=== verify trace enabled ===")
    print(d.get("/apps/%s/trace" % app_id))
    print("=== verify trace-config ===")
    print(d.get("/apps/%s/trace-config?tracing_provider=langfuse" % app_id))


def lf_public_get(d: Dify, path: str) -> Any:
    # 使用 Langfuse web 可达的地址(本机 curl)
    url = path if path.startswith("http") else C.LANGFUSE_URL.rstrip("/") + path
    out, err = d.sh(
        "curl -s -m 20 -u '%s:%s' '%s'"
        % (C.LANGFUSE_PK, C.LANGFUSE_SK, url)
    )
    if err and not out:
        raise RuntimeError("curl failed: %s" % err)
    return json.loads(out)


def find_trace_by_query(d: Dify, query: str) -> str | None:
    for _ in range(12):
        data = lf_public_get(d, "/api/public/traces?limit=5")
        items = data.get("data") or []
        for it in items:
            inp = it.get("input")
            inp_s = json.dumps(inp, ensure_ascii=False)
            if query in inp_s:
                return it.get("id")
        time.sleep(3)
    return None


def main() -> int:
    # homework1 的 HTTP 工具 Agent
    app_id = C.HOMEWORK1_APP_ID
    agent_id = C.HOMEWORK1_AGENT_ID
    query = C.HOMEWORK1_PROBE_QUERY
    tool_name = "getServerStatus"  # operationId

    d = Dify(C.DIFY_EMAIL, C.DIFY_PASSWORD)
    try:
        d.login()
        enable_trace_for_app(d, app_id)

        print("=== 1/3 发 Agent 对话(触发工具调用) ===")
        payload = {
            "inputs": {},
            "query": query,
            "response_mode": "streaming",
            "files": [],
            "conversation_id": "",
        }
        r: dict[str, Any] | None = None
        code = None
        text = ""
        for attempt in range(1, 4):
            print("\n--- agent chat attempt %d/3 ---" % attempt)
            r = d.post(
                "/agent/%s/chat-messages" % agent_id,
                body=payload,
                extra="-m 420 --max-time 420",
                t=450,
            )
            code = r.get("code") if isinstance(r, dict) else None
            text = (r.get("text") or "") if isinstance(r, dict) else ""
            print("chat http:", code)
            print("chat tail:", text[-2000:])
            if code in ("200", "201"):
                break
            if attempt < 3:
                print("[WARN] Agent chat failed; retry after 6s.")
                time.sleep(6)
        if code not in ("200", "201"):
            print("[FAIL] Agent chat failed after retries; code=%r" % code)
            return 1

        # 优先从流式返回里提取 message_id,当作 traceId,避免匹配到旧 trace
        tid = ""
        m = re.search(r'"message_id"\s*:\s*"([0-9a-fA-F-]{36})"', text)
        if m:
            tid = m.group(1)
        else:
            m2 = re.search(r'"id"\s*:\s*"([0-9a-fA-F-]{36})"', text)
            if m2:
                tid = m2.group(1)

        print("\n=== 2/3 在 Langfuse 查 trace(优先流式提取 traceId) ===")
        if not tid:
            tid = find_trace_by_query(d, query) or ""
        if not tid:
            print("[FAIL] 没找到对应 trace:query=%r" % query)
            return 1
        print("traceId:", tid)

        print("\n=== 3/3 拉 observations 并检查工具调用 ===")
        items = []
        for i in range(10):
            time.sleep(3)
            obs = lf_public_get(d, "/api/public/observations?traceId=%s" % tid)
            items = obs.get("data") or []
            if items:
                break
        print("observations count:", len(items))

        tool_items = []
        for it in items:
            if it.get("name") == tool_name or tool_name in (it.get("name") or ""):
                tool_items.append(it)

        # 关键检查:工具调用 observation 是否出现
        if not tool_items:
            print("[FAIL] observations 里找不到工具:%s" % tool_name)
            # 打印前几个观察项,方便你手工对照
            for it in items[:10]:
                print("obs:", it.get("type"), it.get("name"), it.get("id"))
            return 1

        print("tool observation(s):", len(tool_items))
        sample = tool_items[0]
        print("tool type:", sample.get("type"), "name:", sample.get("name"))
        print("tool start/end:", sample.get("startTime"), sample.get("endTime"))

        # 工具输入/输出字段在不同版本字段名可能不同,这里做宽松匹配
        input_s = sample.get("input")
        output_s = sample.get("output")
        input_head = json.dumps(input_s, ensure_ascii=False)[:400] if input_s is not None else ""
        output_head = json.dumps(output_s, ensure_ascii=False)[:400] if output_s is not None else ""
        print("tool input head:", input_head)
        print("tool output head:", output_head)

        if not (input_s or output_s):
            print("[FAIL] tool input/output 为空(需要检查 tracing patch / ingestion 丢弃规则)")
            return 1

        # 生成 token:通常在 type=GENERATION / name=llm 的 observation 或 usage 字段里
        gen = [it for it in items if (it.get("type") or "").upper() == "GENERATION" and (it.get("name") or "") == "llm"]
        if not gen:
            # 宽松一点:找任意 llm generation
            gen = [it for it in items if (it.get("name") or "") == "llm" or (it.get("type") or "").upper() == "GENERATION"]
        if not gen:
            print("[WARN] 没找到 llm generation observation;token 可能只在 trace.input 里。")
            return 0

        usage = gen[0].get("usage") or gen[0].get("usage_details") or {}
        # 兼容几个可能的字段名
        total_tokens = usage.get("totalTokens") or usage.get("total_tokens") or usage.get("total") or gen[0].get("totalTokens")
        print("llm usage totalTokens:", total_tokens)

        print("\n[PASS] Langfuse 已显示工具调用 observation:%s" % tool_name)
        return 0
    finally:
        d.close()


if __name__ == "__main__":
    sys.exit(main())
6.2 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/Langfuse_01_打langfuse_trace补丁_修改后.py(完整脚本)
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""Langfuse 专题 · 步骤 5 · 修改后:给 langfuse_trace.py 补 Observation UUID,重启 worker。"""
from __future__ import annotations

import sys
import time

import _bootstrap  # noqa: F401
import _config as C
import _plugin_util as PU
from dify_api import Dify

LF_TRACE_PATH = (
    "/app/api/.venv/lib/python3.12/site-packages/dify_trace_langfuse/langfuse_trace.py"
)


def patch_container(d: Dify, container: str) -> None:
    content = PU.container_read(d, container, LF_TRACE_PATH)
    already_id = PU.LF_TRACE_MARKER in content
    already_tool_spans_v2 = PU.LF_AGENT_TOOL_SPANS_MARKER_V2 in content
    has_parent_link = "parent_observation_id=langfuse_generation_data.id" in content
    has_gen_id_assignment = "langfuse_generation_data.id = message_id" in content
    if (
        already_id
        and already_tool_spans_v2
        and has_parent_link
        and has_gen_id_assignment
    ):
        print(container, "already patched (id + tool spans v2 with parent link)")
        return
    new_content = PU.apply_langfuse_trace_patch(content)
    new_content = PU.apply_langfuse_agent_tool_spans_patch(new_content)
    PU.container_write(d, container, LF_TRACE_PATH, new_content)
    out, err = d.sh(
        "docker exec %s python -m py_compile %s" % (container, LF_TRACE_PATH)
    )
    print(container, "py_compile:", out or err or "ok")


def main() -> int:
    d = Dify(C.DIFY_EMAIL, C.DIFY_PASSWORD)
    try:
        d.login()
        for ctr in (C.DIFY_WORKER, C.DIFY_API_CTR):
            patch_container(d, ctr)

        print("\n=== restart docker-worker-1 ===")
        out, err = d.sh("docker restart %s" % C.DIFY_WORKER, t=120)
        print(out or err)

        for i in range(15):
            out, _ = d.sh("docker logs --since 30s %s 2>&1 | tail -5" % C.DIFY_WORKER)
            if "ready" in (out or "").lower():
                print("worker ready")
                break
            time.sleep(2)
        else:
            print("[WARN] 未在日志中看到 celery ready,请手动 docker logs -f", C.DIFY_WORKER)

        for ctr in (C.DIFY_WORKER, C.DIFY_API_CTR):
            print(PU.grep_in_container(d, ctr, LF_TRACE_PATH, "auto-assign if missing"))
        return 0
    finally:
        d.close()


if __name__ == "__main__":
    sys.exit(main())
6.3 _plugin_util.py(本作业强相关的完整函数/常量)
以下内容是“你本次作业3最终能通过”的关键实现部分(完整函数级别)。
6.3.1 container_read + marker 常量
def container_read(d, container: str, path: str) -> str:
    out, err = d.sh("docker exec %s cat %s" % (container, path))
    if not out and err:
        raise RuntimeError(err)
    # normalize CRLF -> LF so patch string comparisons work uniformly
    return out.replace("\r\n", "\n")


LF_TRACE_MARKER = "Langfuse v4 requires observation body.id; auto-assign if missing"
LF_AGENT_TOOL_SPANS_MARKER = "# >>> AGENT TOOL SPANS PATCH"
LF_AGENT_TOOL_SPANS_MARKER_V2 = "# >>> AGENT TOOL SPANS PATCH v2"
LF_AGENT_TOOL_SPANS_MARKER_V2 = "# >>> AGENT TOOL SPANS PATCH v2"
6.3.2 apply_langfuse_trace_patch(补 UUID:Generation/Span 的 body.id)
def apply_langfuse_trace_patch(content: str) -> str:
    if LF_TRACE_MARKER in content:
        return content
    old_span = """        data = filter_none_values(langfuse_span_data.model_dump()) if langfuse_span_data else {}
        try:
            body = CreateSpanBody(
                id=data.get("id"),
"""
    new_span = """        data = filter_none_values(langfuse_span_data.model_dump()) if langfuse_span_data else {}
        try:
            # Langfuse v4 requires observation body.id; auto-assign if missing
            if not data.get("id"):
                data["id"] = str(uuid.uuid4())
            body = CreateSpanBody(
                id=data.get("id"),
"""
    old_gen = """            usage_data = data.pop("usage", None)
            usage = None
            if usage_data:
                usage = Usage(
                    input=usage_data.get("input", 0) or 0,
                    output=usage_data.get("output", 0) or 0,
                    total=usage_data.get("total", 0) or 0,
                    unit=usage_data.get("unit"),
                    input_cost=usage_data.get("inputCost"),
                    output_cost=usage_data.get("outputCost"),
                    total_cost=usage_data.get("totalCost"),
                )

            body = CreateGenerationBody(
                id=data.get("id"),
"""
    new_gen = """            usage_data = data.pop("usage", None)
            usage = None
            if usage_data:
                usage = Usage(
                    input=usage_data.get("input", 0) or 0,
                    output=usage_data.get("output", 0) or 0,
                    total=usage_data.get("total", 0) or 0,
                    unit=usage_data.get("unit"),
                    input_cost=usage_data.get("inputCost"),
                    output_cost=usage_data.get("outputCost"),
                    total_cost=usage_data.get("totalCost"),
                )

            # Langfuse v4 requires observation body.id; auto-assign if missing
            if not data.get("id"):
                data["id"] = str(uuid.uuid4())
            body = CreateGenerationBody(
                id=data.get("id"),
"""
    if old_span not in content:
        raise RuntimeError("langfuse_trace.py span 锚点未找到")
    if old_gen not in content:
        raise RuntimeError("langfuse_trace.py generation 锚点未找到")
    content = content.replace(old_span, new_span, 1).replace(old_gen, new_gen, 1)
    return content
6.3.3 apply_langfuse_agent_tool_spans_patch(补工具 span + parent 子链路)
def apply_langfuse_agent_tool_spans_patch(content: str) -> str:
    """在 langfuse_trace.py 的 message_trace() 内补写 mode=agent 的工具调用 spans。

    版本 v2:改用与 ops_trace_manager.tool_trace() 相同的字段名
    (agent_thought.tools / .tool_meta / .observation / .created_at),
    以及 base_agent_runner 保存的 tool_invoke_meta 等字段。
    """

    if LF_AGENT_TOOL_SPANS_MARKER_V2 in content:
        # already has v2 block, but might be missing:
        # 1) stable generation id assignment: langfuse_generation_data.id = message_id
        # 2) parent linking on tool span: parent_observation_id=langfuse_generation_data.id
        has_parent = "parent_observation_id=langfuse_generation_data.id" in content
        has_gen_id = "langfuse_generation_data.id = message_id" in content
        if has_parent and has_gen_id:
            return content

        # targeted fix #1: inject generation id assignment before add_generation
        old_start = (
            "        self.add_generation(langfuse_generation_data)\n\n        "
            + LF_AGENT_TOOL_SPANS_MARKER_V2
            + "\n"
        )
        new_start = (
            "        try:\n"
            "            langfuse_generation_data.id = message_id\n"
            "        except Exception:\n"
            "            pass\n\n"
            "        self.add_generation(langfuse_generation_data)\n\n        "
            + LF_AGENT_TOOL_SPANS_MARKER_V2
            + "\n"
        )
        if old_start in content:
            content = content.replace(old_start, new_start, 1)

        # targeted fix #2: add parent_observation_id to tool spans
        old_trace_line = "                        trace_id=trace_id,\n                        start_time=start_t,\n"
        new_trace_line = (
            "                        trace_id=trace_id,\n"
            "                        parent_observation_id=langfuse_generation_data.id,\n"
            "                        start_time=start_t,\n"
        )
        if old_trace_line in content:
            content = content.replace(old_trace_line, new_trace_line, 1)

        return content

    # 判断是否有旧版补丁,若有则把旧块整体换成 v2
    if LF_AGENT_TOOL_SPANS_MARKER in content:
        old_block_start = "\n        " + LF_AGENT_TOOL_SPANS_MARKER + "\n"
        old_block_end_marker = "agent tool spans patch failed"
        if old_block_start not in content or old_block_end_marker not in content:
            raise RuntimeError("找到旧版 PATCH marker 但无法定位完整旧块边界")
        idx_start = content.index(old_block_start)
        idx_mod = content.index("\n    def moderation_trace", idx_start)
        content = content[:idx_start] + content[idx_mod:]
        old_anchor = (
            "        self.add_generation(langfuse_generation_data)\n\n"
            "    def moderation_trace"
        )
        if old_anchor not in content:
            raise RuntimeError("清除旧块后锚点仍未找到,请手动检查容器文件")
    else:
        old_anchor = (
            "        self.add_generation(langfuse_generation_data)\n\n"
            "    def moderation_trace"
        )
        if old_anchor not in content:
            raise RuntimeError("langfuse_trace.py message_trace 锚点未找到")

    # 完整的补丁插入块(以换行形式展开,避免 f-string 混乱)
    patch_code = (
        "        " + LF_AGENT_TOOL_SPANS_MARKER_V2 + "\n"
        "        # ensure generation id stable so tool spans can link as children\n"
        "        try:\n"
        "            langfuse_generation_data.id = message_id\n"
        "        except Exception:\n"
        "            pass\n"
        "\n"
        "        self.add_generation(langfuse_generation_data)\n"
        "\n"
        "        # mode=agent: derive tool spans from message_data.agent_thoughts\n"
        "        # Uses same fields as ops_trace_manager.tool_trace():\n"
        "        # agent_thought.tools / .tool_meta / .observation / .created_at\n"
        "        try:\n"
        "            agent_thoughts_list = getattr(message_data, 'agent_thoughts', None) or []\n"
        "            for at in agent_thoughts_list:\n"
        "                raw_tools = getattr(at, 'tools', None)\n"
        "                if not raw_tools:\n"
        "                    continue\n"
        "                if isinstance(raw_tools, str):\n"
        "                    tool_name_list = [t.strip() for t in raw_tools.split(',') if t.strip()]\n"
        "                elif isinstance(raw_tools, list):\n"
        "                    tool_name_list = [str(t) for t in raw_tools if t]\n"
        "                else:\n"
        "                    tool_name_list = []\n"
        "\n"
        "                raw_obs = getattr(at, 'observation', None) or ''\n"
        "                obs_map = {}\n"
        "                if isinstance(raw_obs, dict):\n"
        "                    obs_map = raw_obs\n"
        "                elif isinstance(raw_obs, str) and raw_obs:\n"
        "                    if tool_name_list:\n"
        "                        obs_map = {tool_name_list[0]: raw_obs}\n"
        "\n"
        "                raw_tool_input = getattr(at, 'tool_input', None) or ''\n"
        "                input_map = {}\n"
        "                if isinstance(raw_tool_input, dict):\n"
        "                    input_map = raw_tool_input\n"
        "                elif isinstance(raw_tool_input, str) and raw_tool_input:\n"
        "                    try:\n"
        "                        parsed = json.loads(raw_tool_input)\n"
        "                        if isinstance(parsed, dict):\n"
        "                            input_map = parsed\n"
        "                        else:\n"
        "                            input_map = {tool_name_list[0]: raw_tool_input} if tool_name_list else {}\n"
        "                    except Exception:\n"
        "                        input_map = {tool_name_list[0]: raw_tool_input} if tool_name_list else {}\n"
        "\n"
        "                tool_meta_raw = getattr(at, 'tool_meta', None) or {}\n"
        "                at_start = getattr(at, 'created_at', None) or trace_info.start_time\n"
        "\n"
        "                for tn in tool_name_list:\n"
        "                    tool_output = obs_map.get(tn, obs_map.get(None) if len(tool_name_list) == 1 else None)\n"
        "                    if tool_output is None and len(obs_map) == 1:\n"
        "                        tool_output = next(iter(obs_map.values()), None)\n"
        "                    tool_inp = input_map.get(tn, input_map.get(None))\n"
        "                    if tool_inp is None and len(input_map) == 1:\n"
        "                        tool_inp = next(iter(input_map.values()), None)\n"
        "\n"
        "                    tmeta = tool_meta_raw.get(tn, {}) if isinstance(tool_meta_raw, dict) else {}\n"
        "                    time_cost_s = tmeta.get('time_cost', 0) or 0\n"
        "                    try:\n"
        "                        time_cost_f = float(time_cost_s)\n"
        "                    except (TypeError, ValueError):\n"
        "                        time_cost_f = 0.0\n"
        "\n"
        "                    start_t = at_start\n"
        "                    end_t = start_t + timedelta(seconds=time_cost_f) if start_t else None\n"
        "                    err = tmeta.get('error')\n"
        "\n"
        "                    tool_span = LangfuseSpan(\n"
        "                        name=tn,\n"
        "                        input=tool_inp,\n"
        "                        output=tool_output,\n"
        "                        trace_id=trace_id,\n"
        "                        parent_observation_id=langfuse_generation_data.id,\n"
        "                        start_time=start_t,\n"
        "                        end_time=end_t,\n"
        "                        metadata={**metadata, 'tool_name': tn, 'time_cost': time_cost_f},\n"
        "                        level=(LevelEnum.DEFAULT if not err else LevelEnum.ERROR),\n"
        "                        status_message=err,\n"
        "                    )\n"
        "                    self.add_span(langfuse_span_data=tool_span)\n"
        "        except Exception:\n"
        "            logger.exception('agent tool spans patch v2 failed')\n"
        "\n"
        "    def moderation_trace"
    )

    return content.replace(old_anchor, patch_code, 1)
7. 最小复现清单(你要交作业/验收时的顺序)
按下面顺序做(确保每次都在你自己的环境运行):
/usr/bin/python3 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/Langfuse_01_打langfuse_trace补丁_修改后.py/usr/bin/python3 /opt/workbuddy/scripts_cursor/作业3_追踪Agent工具调用验收/作业3_验收Langfuse工具调用.py- (可选核对)207 上:
curl -s -u 'pk-lf-84a76d89-b6b4-4943-b4ea-2dee48d4cda7:sk-lf-24aa6d73-ed36-4447-9eb6-3ebd446fb298' 'http://192.168.110.207:3000/api/public/observations?traceId=<本次 message_id>'
- 打开 Langfuse UI
http://192.168.110.207:3000:
Tracing -> Observations- 筛选
Name=getServerStatus - 点击条目确认 Input/Output/耗时/metadata
8. 收尾建议
- 建议你把一次验收成功时的
traceId复制到文档/笔记里(以后你只需换 traceId 就能快速核验) - 如果未来你换了
tool_name或 agent,你只需要改验收脚本里tool_name = ...,以及工具本身返回结构即可